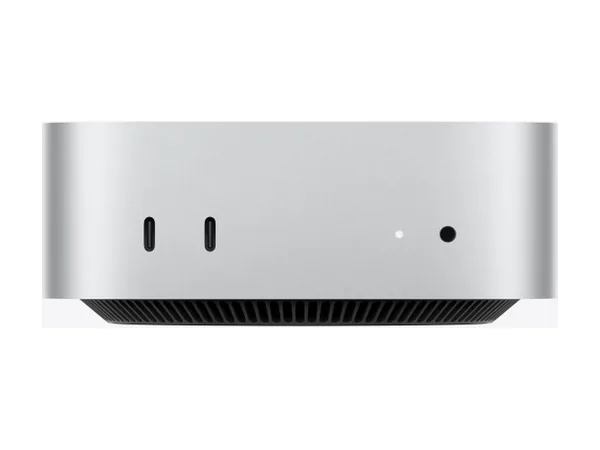
Mac miniDisponible
Mac mini M5 Pro
15-core CPU / 16-core GPU, 24GB
1 699 $ USchez Apple Store
24 Go · 307 Go/s · ~17 Go utilisables
Voir le prixGuide mémoire · RAM et VRAM
Règle simple : en 4 bits, un modèle demande environ 0,6 Go par milliard de paramètres, plus un peu pour le contexte, et le 8 bits (Q8_0) environ 1,7 fois plus. Ainsi, GPT-OSS 20B demande ~13 Go, Llama 3.3 70B ~46 Go, GPT-OSS 120B ~67 Go et Qwen3 235B-A22B ~151 Go.
La mémoire décide si un modèle tourne; la bande passante décide à quelle vitesse. Ci-dessous : chaque modèle suivi, ce qu’il demande et la machine la moins chère qui le contient.
| Modèle | 4 bits | 8 bits (Q8_0) | Machine suivie la moins chère où il rentre (4 bits) |
|---|---|---|---|
| Qwen3.5 9B9B au total, dense | ~7 GoQ4_K_M | ~12 Go | Mac mini M5 Pro1 699 $ US · ~48 tok/s |
| Gemma 4 12B12B au total, dense | ~9 GoQ4_K_M | ~15 Go | Mac mini M5 Pro1 699 $ US · ~36 tok/s |
| GPT-OSS 20B21B au total, 3.6B actifs (MoE) | ~13 GoMXFP4 (native) | ~25 Go | Mac mini M5 Pro1 699 $ US · ~82 tok/s |
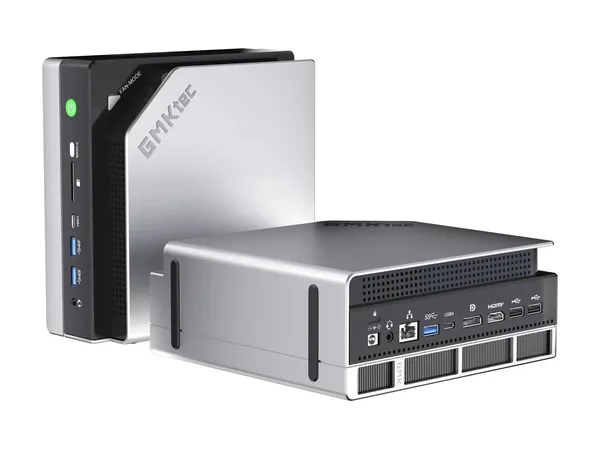
| Gemma 4 26B-A4B25.2B au total, 3.8B actifs (MoE) | ~18 GoQ4_K_M | ~30 Go | GMKtec EVO-X22 200 $ US · ~61 tok/s |
| Qwen3.8 27B27B au total, dense | ~19 GoQ4_K_M | ~32 Go | GMKtec EVO-X22 200 $ US · ~12 tok/s |
| GLM-4.7-Flash 30B-A3B30B au total, 3B actifs (MoE) | ~21 GoQ4_K_M | ~35 Go | GMKtec EVO-X22 200 $ US · ~72 tok/s |
| Gemma 4 31B31B au total, dense | ~21 GoQ4_K_M | ~36 Go | GMKtec EVO-X22 200 $ US · ~11 tok/s |
| Qwen3.6 35B-A3B35B au total, 3B actifs (MoE) | ~24 GoQ4_K_M | ~41 Go | GMKtec EVO-X22 200 $ US · ~72 tok/s |
| Llama 3.3 70B70B au total, dense | ~46 GoQ4_K_M | ~80 Go | GMKtec EVO-X22 200 $ US · ~5 tok/s |
| Qwen3-Next 80B-A3B80B au total, 3B actifs (MoE) | ~52 GoQ4_K_M | ~91 Go | GMKtec EVO-X23 500 $ US · ~72 tok/s |
| Llama 4 Scout 109B-A17B109B au total, 17B actifs (MoE) | ~71 GoQ4_K_M | ~123 Go | GMKtec EVO-X23 500 $ US · ~18 tok/s |
| GPT-OSS 120B117B au total, 5.1B actifs (MoE) | ~67 GoMXFP4 (native) | ~132 Go | GMKtec EVO-X23 500 $ US · ~55 tok/s |
| Nemotron 3 Super 120B-A12B120B au total, 12B actifs (MoE) | ~78 GoQ4_K_M | ~135 Go | GMKtec EVO-X23 500 $ US · ~25 tok/s |
| Qwen3.5 122B-A10B122B au total, 10B actifs (MoE) | ~79 GoQ4_K_M | ~138 Go | GMKtec EVO-X23 500 $ US · ~29 tok/s |
| Qwen3 235B-A22B235B au total, 22B actifs (MoE) | ~151 GoQ4_K_M | ~264 Go | Aucune machine suivie avec prix |
| Muse Spark Open 816B-A42B816B au total, 42B actifs (MoE) | ~521 GoQ4_K_M | ~912 Go | Aucune machine suivie avec prix |
Mémoire = poids + 1,5 Go + 5 % des poids (~8K de contexte, un utilisateur); poids = paramètres × bits par poids ÷ 8 (Q4_K_M 4,85 bits par poids, Q8_0 8,5). Les vitesses sont nos estimations. Notre méthode
| Mémoire | Plus gros modèle qui rentre | Plus gros modèle dense | Modèles qui rentrent |
|---|---|---|---|
| 8 Go de VRAM~7 Go utilisables | Qwen3.5 9B | Qwen3.5 9B | 1 sur 16 |
| 12 Go de VRAM~11 Go utilisables | Gemma 4 12B | Gemma 4 12B | 2 sur 16 |
| 16 Go de VRAM~15 Go utilisables | GPT-OSS 20B | Gemma 4 12B | 3 sur 16 |
| 24 Go de VRAM~22 Go utilisables | Gemma 4 31B | Gemma 4 31B | 7 sur 16 |
| 32 Go de VRAM~30 Go utilisables | Qwen3.6 35B-A3B | Gemma 4 31B | 8 sur 16 |
| 64 Go de mémoire unifiée~48 Go utilisables | Llama 3.3 70B | Llama 3.3 70B | 9 sur 16 |
| 96 Go de mémoire unifiée~72 Go utilisables | GPT-OSS 120B | Llama 3.3 70B | 12 sur 16 |
| 128 Go de mémoire unifiée~96 Go utilisables | Qwen3.5 122B-A10B | Llama 3.3 70B | 14 sur 16 |
Tailles génériques : VRAM des cartes comptée à 93 % utilisable, mémoire unifiée (Mac, Strix Halo) à 75 %. Les boîtiers DGX Spark ont ~85 %.
15-core CPU / 16-core GPU, 24GB
24 Go · 307 Go/s · ~17 Go utilisables
Voir le prixRyzen AI Max+ 395, 64GB / 1TB
64 Go · 256 Go/s · ~48 Go utilisables
Voir le prixRyzen AI Max+ 395, 128GB / 1TB
128 Go · 256 Go/s · ~96 Go utilisables
Voir le prixLa machine avec prix la moins chère où rentre chaque modèle ci-dessus, sans doublons. Prix US en dollars américains (USD), hors taxes et livraison.
En 4 bits (Q4_K_M), environ 0,6 Go par milliard de paramètres, plus ~1,5 Go et 5 % pour ~8K de contexte : ~7 Go pour un modèle de 9B, ~19 Go pour 27B, ~46 Go pour 70B. Les cartes graphiques laissent ~93 % de la VRAM utilisable.
Environ 46 Go en 4 bits et 80 Go en 8 bits. Sur un Mac ou un Strix Halo, seulement ~75 % de la RAM est utilisable par le GPU par défaut : 64 Go, c’est juste en 4 bits, et 96 à 128 Go, c’est confortable.
Environ 151 Go en 4 bits et 264 Go en 8 bits. Les modèles à mélange d’experts ont besoin de mémoire pour tous leurs poids, même si seulement 22B sont lus à chaque jeton. Aucune machine suivie avec prix ne le contient en 4 bits en ce moment.
Non : il faut de la mémoire pour chaque paramètre, mais il tourne plus vite car chaque jeton ne lit que les paramètres actifs. GPT-OSS 120B demande ~67 Go mais ne lit que 5.1B paramètres par jeton.
Prenez une quantification plus petite (Q3 ou moins, au prix de la qualité), un modèle plus petit, ou déchargez des couches vers la RAM système, ce qui fonctionne mais est beaucoup plus lent. Les longs contextes (32K et plus) demandent plus de mémoire que ces chiffres.
Un court courriel par semaine (en anglais pour l’instant) : ce qui a baissé, ce qui est de retour en stock et les nouveaux modèles ouverts que votre machine peut faire tourner. Désabonnement en un clic.