GMKtec EVO-X2
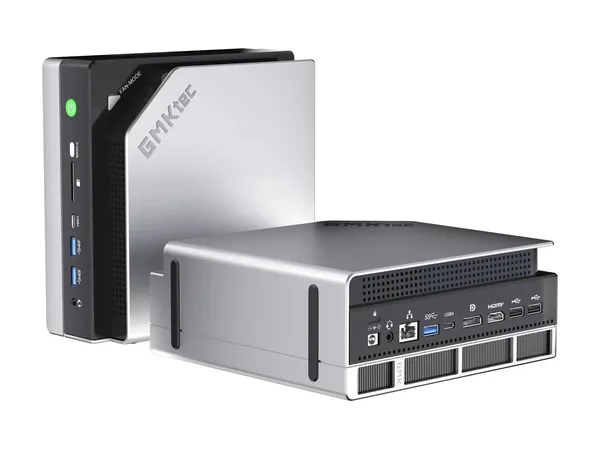
Ryzen AI Max+ 395, 64GB / 1TB
La moins chère qui le fait tourner. Le prix le plus bas vu parmi les machines suivies qui contiennent Llama 3.3 70B en 4 bits (46 sur 48 Go utilisables).
Meta · 70B au total / 70B actifs · dense
Pour faire tourner Llama 3.3 70B en local, il faut environ 46 Go de mémoire en Q4_K_M, et 12 des 17 machines suivies avec un prix peuvent le contenir. La moins chère est le GMKtec EVO-X2 à 2 200 $ US (~5 tok/s est.); la plus rapide est le PNY NVIDIA RTX PRO 6000 Blackwell, à ~34 tok/s.
Ryzen AI Max+ 395, 64GB / 1TB
La moins chère qui le fait tourner. Le prix le plus bas vu parmi les machines suivies qui contiennent Llama 3.3 70B en 4 bits (46 sur 48 Go utilisables).
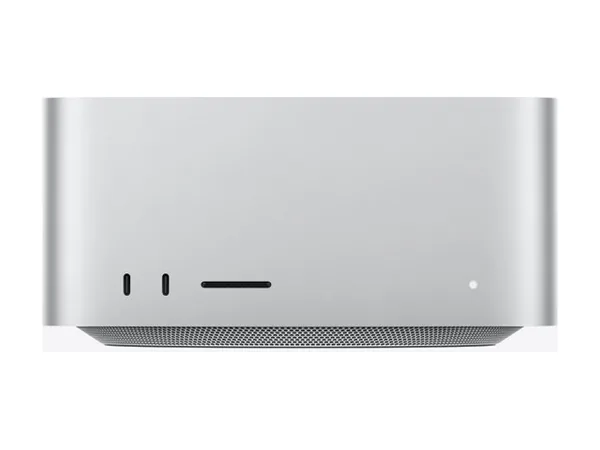
30-core CPU / 64-core GPU, 96GB
Meilleur rapport qualité-prix. Le plus bas prix par jeton/s parmi les systèmes complets où il rentre à l’aise : environ 241,41 $ US par tok/s en 4 bits.
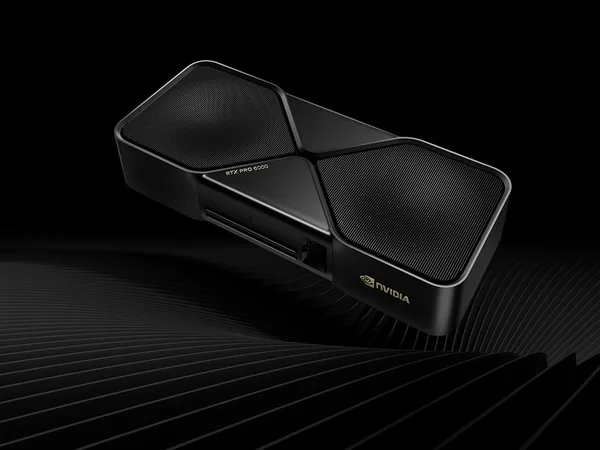
96GB card
La plus rapide. La plus grande bande passante mémoire parmi les machines où il rentre (1 792 Go/s), donc la génération la plus rapide : ~34 tok/s en 4 bits.
Quantification conseillée : Q8_0 (~20 tok/s)
Prix de la carte seule : il vous faut encore un PC hôte.
Voir le prixUtilisez Q4_K_M sur la plupart des machines : il faut ~46 Go. Le Q8_0 (~80 Go) est un peu plus précis et rentre à l’aise sur 1 de ces machines, par exemple le PNY NVIDIA RTX PRO 6000 Blackwell.
| Machine | Prix US (USD) | Compatibilité et vitesse en 4 bits | Quantification conseillée | $ US par tok/s |
|---|---|---|---|---|
| GMKtec EVO-X2Strix Halo | 2 200 $ US | Juste~5 tok/s | Q4_K_M | 456,09 $ US |
| GMKtec EVO-X2Strix Halo | 3 500 $ US | Rentre~5 tok/s | Q4_K_M | 725,60 $ US |
| Minisforum MS-S1 MaxStrix Halo | 3 919 $ US | Rentre~5 tok/s | Q4_K_M | 812,46 $ US |
| Beelink GTR9 ProStrix Halo | 4 349 $ US | Rentre~5 tok/s | Q4_K_M | 901,61 $ US |
| Framework Desktop DIYStrix Halo | 4 839 $ US | Rentre~5 tok/s | Q4_K_M | 1 003 $ US |
| Mac Studio M5 UltraMac Studio | 5 499 $ US | Rentre~23 tok/s | Q4_K_M | 241,41 $ US |
| Lenovo ThinkStation PGXDGX Spark / GB10 | 5 859 $ US | Rentre~5 tok/s | Q4_K_M | 1 183 $ US |
| ASUS Ascent GX10DGX Spark / GB10 | 5 999 $ US | Rentre~5 tok/s | Q4_K_M | 1 211 $ US |
| NVIDIA DGX SparkDGX Spark / GB10 | 6 950 $ US | Rentre~5 tok/s | Q4_K_M | 1 403 $ US |
| HP ZGX Nano G1nDGX Spark / GB10 | 7 699 $ US | Rentre~5 tok/s | Q4_K_M | 1 554 $ US |
| Gigabyte AI TOP ATOMDGX Spark / GB10 | 8 499 $ US | Rentre~5 tok/s | Q4_K_M | 1 716 $ US |
| PNY NVIDIA RTX PRO 6000 BlackwellRTX PRO 6000 (carte seule, il faut un PC hôte) | 17 899 $ US | Rentre~34 tok/s | Q8_0 | 528,60 $ US |
Trié du moins cher au plus cher. Vitesses de génération estimées pour un utilisateur avec ~8K de contexte. Tableau complet, y compris les machines où il ne rentre pas : mémoire nécessaire pour Llama 3.3 70B. Notre méthode
Environ 46 Go en Q4_K_M et 80 Go en Q8_0, environnement d’exécution et ~8K jetons de contexte compris, pour un utilisateur. Un contexte plus long demande davantage.
Parmi les machines que nous suivons, le GMKtec EVO-X2 à 2 200 $ US, avec ~5 tok/s estimés en 4 bits. Prix US vérifiés le 2026-10-24.
Q4_K_M est le choix par défaut : environ 46 Go. Le Q8_0 demande environ 80 Go; ne l’utilisez que si vous avez la place et gardez une vitesse utilisable.
Il a 70B paramètres actifs par jeton : la vitesse dépend donc de la bande passante mémoire, de ~5 tok/s sur la machine la plus lente où il rentre à ~34 tok/s sur le PNY NVIDIA RTX PRO 6000 Blackwell. Ce sont des estimations, pas des bancs d’essai.
Un court courriel par semaine (en anglais pour l’instant) : ce qui a baissé, ce qui est de retour en stock et les nouveaux modèles ouverts que votre machine peut faire tourner. Désabonnement en un clic.