RTX 4090En stock
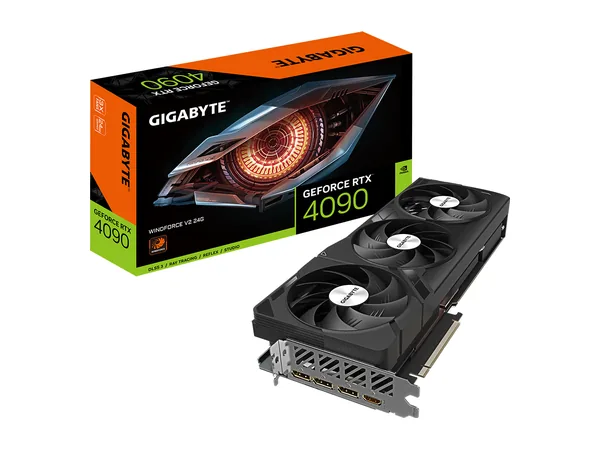
Gigabyte GeForce RTX 4090 Windforce V2
24GB card
4 899 $ USchez Newegg
24 Go de VRAM · 1 008 Go/s
Prix de la carte seule : il vous faut encore un PC hôte.
Voir le prixGuide des cartes graphiques
Pour les LLM en local, la VRAM d’une carte graphique décide des modèles qui rentrent, et sa bande passante mémoire décide de leur vitesse. Nous suivons 3 cartes. La PNY NVIDIA RTX PRO 6000 Blackwell accepte les plus gros modèles (96 Go) et c’est aussi la moins chère par Go de VRAM en ce moment (186,45 $ US par Go).
Le prix des cartes n’inclut pas le PC hôte.
| Carte | Prix US (carte seule) | VRAM | Utilisable pour les modèles | Bande passante | $ US / Go |
|---|---|---|---|---|---|
| Gigabyte GeForce RTX 4090 Windforce V2 | 4 899 $ US | 24 Go | ~22 Go | 1 008 Go/s | 204,12 $ US |
| NVIDIA GeForce RTX 5090 Founders Edition | 8 500 $ US | 32 Go | ~30 Go | 1 792 Go/s | 265,62 $ US |
| PNY NVIDIA RTX PRO 6000 Blackwell | 17 899 $ US | 96 Go | ~89 Go | 1 792 Go/s | 186,45 $ US |
| Modèle | RTX 4090 Windforce V224 Go · 4 899 $ US | RTX 5090 Founders Edition32 Go · 8 500 $ US | RTX PRO 6000 Blackwell96 Go · 17 899 $ US |
|---|---|---|---|
| Qwen3.5 9B~7 Go en 4 bits | Rentre~133 tok/s | Rentre~214 tok/s | Rentre~214 tok/s |
| GPT-OSS 20B~13 Go en 4 bits | Rentre~209 tok/s | Rentre~264 tok/s | Rentre~264 tok/s |
| Qwen3.6 35B-A3B~24 Go en 4 bits | Ne rentre pas | Rentre~269 tok/s | Rentre~269 tok/s |
| Qwen3.8 27B~19 Go en 4 bits | Rentre~49 tok/s | Rentre~83 tok/s | Rentre~83 tok/s |
| Gemma 4 31B~21 Go en 4 bits | Juste~43 tok/s | Rentre~73 tok/s | Rentre~73 tok/s |
| Llama 3.3 70B~46 Go en 4 bits | Ne rentre pas | Ne rentre pas | Rentre~34 tok/s |
| GPT-OSS 120B~67 Go en 4 bits | Ne rentre pas | Ne rentre pas | Rentre~231 tok/s |
| Qwen3.5 122B-A10B~79 Go en 4 bits | Ne rentre pas | Ne rentre pas | Rentre~152 tok/s |
Génération estimée pour un utilisateur avec ~8K de contexte, modèle entièrement en VRAM (sans déchargement vers la RAM système). Notre méthode
| Matériel | Modèle / essai | tok/s mesurés | Notre formule | Source |
|---|---|---|---|---|
| RTX PRO 60001 792 Go/s | Llama-2 7B Q4_0llama.cpp tg128 | 274,2 | 280,4 | source |
| RTX PRO 60001 792 Go/s | Llama 3.3 70B Q4_K_Mllama.cpp tg128 | 34,0 | 33,8 | source |
| RTX PRO 60001 792 Go/s | gpt-oss-120b MXFP4llama.cpp tg128 | 196,3 | 231,4 | source |
| RTX PRO 60001 792 Go/s | gpt-oss-20b MXFP4llama.cpp tg128 | 286,9 | 264,1 | source |
| RTX 50901 792 Go/s | Llama-2 7B Q4_0llama.cpp tg128 | 290,0 | 280,4 | source |
| RTX 50901 792 Go/s | Qwen3.6-27B Q4_K_Mllama.cpp tg128 | 77,1 | 81,3 | source |
| RTX 50901 792 Go/s | Qwen3.6-35B-A3B UD-Q4_K_Mllama.cpp tg128 | 271,0 | 268,6 | source |
| RTX 50901 792 Go/s | gpt-oss-20b MXFP4llama.cpp tg128 | 282,5 | 264,1 | source |
| RTX 40901 008 Go/s | Llama-2 7B Q4_0llama.cpp tg128 | 186,2 | 179,8 | source |
| RTX 40901 008 Go/s | Qwen3 32B Q4_K_Mllama.cpp tg128 | 42,0 | 40,4 | source |
| RTX 40901 008 Go/s | gpt-oss-20b MXFP4llama.cpp tg128 | 222,0 | 208,9 | source |
| RTX 40901 008 Go/s | Qwen3 30B-A3B Q4_K_Mllama.cpp tg128 (fusion off) | 198,4 | 204,4 | source |
| RTX PRO 60001 792 Go/s | gpt-oss-120b MXFP4llama.cpp 4K ctx (newer build) | 221,3 | 231,4 | source |
| RTX 50901 792 Go/s | Qwen3 30B-A3B Q4_K_Mllama.cpp + GGML_CUDA_GRAPH_OPT=1 | 352,1 | 260,1 | source |
| RTX 50901 792 Go/s | gpt-oss-20b MXFP4llama.cpp + GGML_CUDA_GRAPH_OPT=1 | 419,1 | 264,1 | source |
Résultats publics llama.cpp utilisés pour la calibration. Les versions récentes et les options CUDA graph peuvent être plus rapides. Liste complète : nos estimations face à 52 vrais bancs d’essai.
24GB card
24 Go de VRAM · 1 008 Go/s
Prix de la carte seule : il vous faut encore un PC hôte.
Voir le prix32GB card
32 Go de VRAM · 1 792 Go/s
Prix de la carte seule : il vous faut encore un PC hôte.
Voir le prix96GB card
96 Go de VRAM · 1 792 Go/s
Prix de la carte seule : il vous faut encore un PC hôte.
Voir le prixTout dépend de la taille du modèle. Parmi les cartes que nous suivons, la PNY NVIDIA RTX PRO 6000 Blackwell a le plus de VRAM (96 Go) : elle fait tourner des modèles denses de 70B et des MoE de la classe 120B sur une seule carte. Pour les modèles de 20 à 35B, une carte de 24 à 32 Go suffit et coûte bien moins cher.
Environ 13 Go pour GPT-OSS 20B, 19 Go pour un modèle de 27B et 46 Go pour Llama 3.3 70B en 4 bits, avec ~8K de contexte. Les cartes dédiées laissent ~93 % de la VRAM utilisable.
La RTX 5090 a 32 Go et 1 792 Go/s, contre 24 Go et 1 008 Go/s pour la 4090 : elle accepte donc de plus gros modèles et génère environ 1,3 à 1,7× plus vite sur les modèles que les deux peuvent contenir (notre estimation). En ce moment, la 5090 que nous suivons coûte 8 500 $ US et la 4090 4 899 $ US (carte seule).
Les cartes graphiques sont bien plus rapides sur les modèles qui rentrent dans leur VRAM et mènent pour le traitement du prompt. Les boîtiers à mémoire unifiée sont plus lents par jeton, mais acceptent des modèles bien plus gros pour le même prix : une carte de 96 à 128 Go coûte bien plus cher qu’un mini PC de 128 Go.
Un court courriel par semaine (en anglais pour l’instant) : ce qui a baissé, ce qui est de retour en stock et les nouveaux modèles ouverts que votre machine peut faire tourner. Désabonnement en un clic.