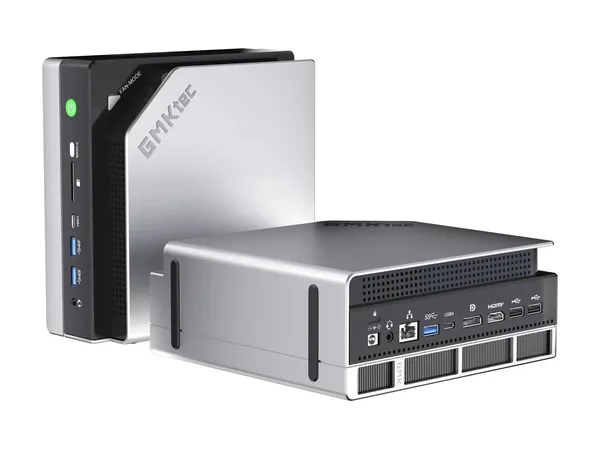
Strix HaloDisponible
GMKtec EVO-X2
Ryzen AI Max+ 395, 128GB / 1TB
3 500 $ USchez GMKtec store
256 Go/s
Voir le prixGuide mémoire · 128 Go de mémoire unifiée
Avec 128 Go de mémoire unifiée, 14 des 16 modèles ouverts populaires de notre sélecteur rentrent sans déborder dans la RAM système, le plus gros étant Qwen3.5 122B-A10B. La vitesse va d’environ 5 à 72 jetons/s selon le modèle et la machine.
La machine suivie la moins chère avec 128 Go de mémoire unifiée est le GMKtec EVO-X2 à 3 500 $ US.
| Modèle | Mémoire en 4 bits | Strix Halo256 Go/s | DGX Spark273 Go/s |
|---|---|---|---|
| Qwen3.5 9Bdense · 9B actifs · chat, petits agents | ~7 Go | Rentre~21 tok/sQ8_0 | Rentre~22 tok/sQ8_0 |
| Gemma 4 12Bdense · 12B actifs · chat, vision | ~9 Go | Rentre~16 tok/sQ8_0 | Rentre~16 tok/sQ8_0 |
| GPT-OSS 20BMoE · 3.6B actifs · raisonnement, outils | ~13 Go | Rentre~42 tok/sQ8_0 | Rentre~46 tok/sQ8_0 |
| Gemma 4 26B-A4BMoE · 3.8B actifs · chat général rapide | ~18 Go | Rentre~40 tok/sQ8_0 | Rentre~44 tok/sQ8_0 |
| Qwen3.8 27Bdense · 27B actifs · code, vision, usage général | ~19 Go | Rentre~12 tok/sQ4_K_M | Rentre~13 tok/sQ4_K_M |
| GLM-4.7-Flash 30B-A3BMoE · 3B actifs · agents de code | ~21 Go | Rentre~48 tok/sQ8_0 | Rentre~54 tok/sQ8_0 |
| Gemma 4 31Bdense · 31B actifs · général, vision | ~21 Go | Rentre~11 tok/sQ4_K_M | Rentre~11 tok/sQ4_K_M |
| Qwen3.6 35B-A3BMoE · 3B actifs · code et chat rapides | ~24 Go | Rentre~48 tok/sQ8_0 | Rentre~54 tok/sQ8_0 |
| Llama 3.3 70Bdense · 70B actifs · usage général | ~46 Go | Rentre~5 tok/sQ4_K_M | Rentre~5 tok/sQ4_K_M |
| Qwen3-Next 80B-A3BMoE · 3B actifs · long contexte, rapide | ~52 Go | Rentre~72 tok/sQ4_K_M | Rentre~54 tok/sQ8_0 |
| Llama 4 Scout 109B-A17BMoE · 17B actifs · multimodal, long contexte | ~71 Go | Rentre~18 tok/sQ4_K_M | Rentre~19 tok/sQ4_K_M |
| GPT-OSS 120BMoE · 5.1B actifs · raisonnement, outils | ~67 Go | Rentre~55 tok/sMXFP4 (native) | Rentre~61 tok/sMXFP4 (native) |
| Nemotron 3 Super 120B-A12BMoE · 12B actifs · agents | ~78 Go | Rentre~25 tok/sQ4_K_M | Rentre~26 tok/sQ4_K_M |
| Qwen3.5 122B-A10BMoE · 10B actifs · très bon en général et en code | ~79 Go | Rentre~29 tok/sQ4_K_M | Rentre~31 tok/sQ4_K_M |
Chaque colonne indique la quantification que nous choisirions (8 bits si le modèle rentre à l’aise et tourne encore à 10 tok/s ou plus, sinon 4 bits) et la vitesse de génération estimée pour un utilisateur, avec ~8K de contexte. Notre méthode
Juste hors de portée : Qwen3 235B-A22B (~151 Go en 4 bits), Muse Spark Open 816B-A42B (~521 Go en 4 bits).
Ryzen AI Max+ 395, 128GB / 1TB
256 Go/s
Voir le prixRyzen AI Max+ 395, 128GB / 2TB
256 Go/s
Voir le prixRyzen AI Max+ 395, 128GB / 2TB
256 Go/s
Voir le prixRyzen AI Max+ 395, 128GB
256 Go/s
Voir le prixFounders Edition, 4TB
273 Go/s
Voir le prixParmi les modèles que nous suivons, Qwen3.5 122B-A10B est le plus gros qui rentre entièrement dans 128 Go de mémoire unifiée (Q4_K_M, environ 79 Go avec l’environnement d’exécution et ~8K de contexte).
Parmi les machines que nous suivons, le GMKtec EVO-X2 à 3 500 $ US (GMKtec store, vérifié le 2026-10-24). Prix US en USD.
Oui. En 4 bits, il faut environ 46 Go, environnement d’exécution et ~8K de contexte compris.
Mémoire nécessaire = poids + 1,5 Go + 5 % des poids. Vitesse de génération ≈ 1 ÷ (poids actifs en Go ÷ (efficacité × bande passante mémoire) + un petit surcoût fixe par jeton), l’efficacité et le surcoût étant calibrés par plateforme sur 43 bancs d’essai publics llama.cpp/MLX (erreur médiane d’environ 5 %). Ce sont des estimations, pas des bancs d’essai.
Un court courriel par semaine (en anglais pour l’instant) : ce qui a baissé, ce qui est de retour en stock et les nouveaux modèles ouverts que votre machine peut faire tourner. Désabonnement en un clic.