Strix HaloDisponible
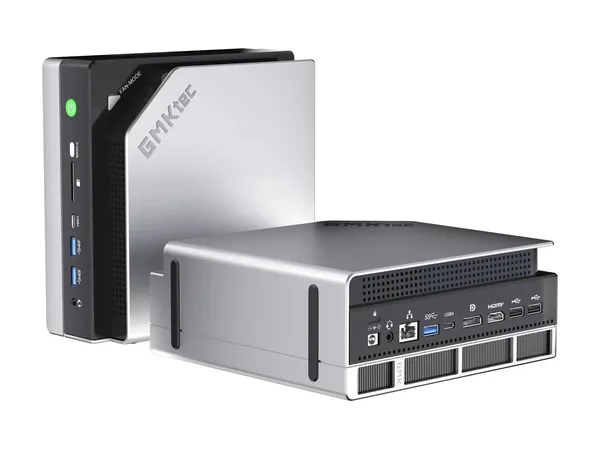
GMKtec EVO-X2
Ryzen AI Max+ 395, 64GB / 1TB
2 200 $ USchez GMKtec store
64 Go · 256 Go/s · ~48 Go utilisables
Voir le prixGuide de plateforme · AMD Strix Halo
Oui pour les gros modèles à mélange d’experts, moins pour les gros modèles denses. Les mini PC Strix Halo (AMD Ryzen AI Max+ 395) associent jusqu’à 128 Go de mémoire unifiée à 256 Go/s, à partir de 2 200 $ US (64 Go) et 3 500 $ US pour 128 Go.
Cette mémoire contient des MoE de la classe 120B comme Qwen3.5 122B-A10B, à ~29 tok/s, mais un modèle dense comme Llama 3.3 70B se traîne à ~5 tok/s.
| Modèle | Compatibilité et vitesse est. |
|---|---|
| Qwen3.5 9B~7 Go en 4 bits, dense | Rentre~37 tok/s |
| Gemma 4 12B~9 Go en 4 bits, dense | Rentre~28 tok/s |
| GPT-OSS 20B~13 Go en 4 bits, 3.6B actifs | Rentre~69 tok/s |
| Gemma 4 26B-A4B~18 Go en 4 bits, 3.8B actifs | Rentre~61 tok/s |
| Qwen3.8 27B~19 Go en 4 bits, dense | Rentre~12 tok/s |
| GLM-4.7-Flash 30B-A3B~21 Go en 4 bits, 3B actifs | Rentre~72 tok/s |
| Gemma 4 31B~21 Go en 4 bits, dense | Rentre~11 tok/s |
| Qwen3.6 35B-A3B~24 Go en 4 bits, 3B actifs | Rentre~72 tok/s |
| Llama 3.3 70B~46 Go en 4 bits, dense | Rentre~5 tok/s |
| Qwen3-Next 80B-A3B~52 Go en 4 bits, 3B actifs | Rentre~72 tok/s |
| Llama 4 Scout 109B-A17B~71 Go en 4 bits, 17B actifs | Rentre~18 tok/s |
| GPT-OSS 120B~67 Go en 4 bits, 5.1B actifs | Rentre~55 tok/s |
| Nemotron 3 Super 120B-A12B~78 Go en 4 bits, 12B actifs | Rentre~25 tok/s |
| Qwen3.5 122B-A10B~79 Go en 4 bits, 10B actifs | Rentre~29 tok/s |
Génération estimée pour un utilisateur avec ~8K de contexte sur le GMKtec EVO-X2 (~96 Go utilisables, 256 Go/s). Notre méthode
| Matériel | Modèle / essai | tok/s mesurés | Notre formule | Source |
|---|---|---|---|---|
| Strix Halo256 Go/s | Llama-2 7B Q4_0llama.cpp Vulkan tg128 | 52,7 | 53,4 | source |
| Strix Halo256 Go/s | Qwen3 8B Q4_K_Mllama.cpp Vulkan tg128 | 41,4 | 40,7 | source |
| Strix Halo256 Go/s | Mistral Small 24B Q4_K_Mllama.cpp Vulkan tg128 | 14,3 | 14,3 | source |
| Strix Halo256 Go/s | Llama 3.3 70B Q4_K_Mllama.cpp Vulkan tg128 | 4,8 | 4,8 | source |
| Strix Halo256 Go/s | Qwen3 30B-A3B Q4_K_Mllama.cpp Vulkan tg128 | 85,5 | 67,3 | source |
| Strix Halo256 Go/s | Qwen3 30B-A3B UD-Q4_K_XLllama.cpp Vulkan tg128 | 75,3 | 67,3 | source |
| Strix Halo256 Go/s | Qwen3-Coder-Next 80B-A3B Q4_K_Mllama.cpp Vulkan tg128 | 57,5 | 71,5 | source |
| Strix Halo256 Go/s | Llama 4 Scout UD-Q4_K_XLllama.cpp Vulkan tg128 | 20,2 | 18,0 | source |
| Strix Halo256 Go/s | gpt-oss-120b MXFP4llama.cpp ROCm tg128 | 47,5 | 54,6 | source |
| Strix Halo256 Go/s | Qwen3 235B-A22B IQ3_XSllama.cpp Vulkan tg128 | 18,1 | 20,2 | source |
| Strix Halo256 Go/s | Qwen3.6 35B-A3B Q4_K_MOllama/llama.cpp | 63,0 | 71,5 | source |
| Framework Desktop (Strix Halo)256 Go/s | Llama 3.1 70B Q4_K_MOllama (Geerling) | 5,0 | 4,8 | source |
Résultats publics llama.cpp / Ollama utilisés pour la calibration. Liste complète : nos estimations face à 52 vrais bancs d’essai.
| Machine | Prix US (USD) | Mémoire | Bande passante | GPT-OSS 120B | Llama 3.3 70B |
|---|---|---|---|---|---|
| GMKtec EVO-X2Strix Halo | 3 500 $ US | 128 Go | 256 Go/s | Rentre~55 tok/s | Rentre~5 tok/s |
| Lenovo ThinkStation PGXDGX Spark / GB10 | 5 859 $ US | 128 Go | 273 Go/s | Rentre~61 tok/s | Rentre~5 tok/s |
| Mac Studio M5 UltraMac Studio | 5 499 $ US | 96 Go | 1 200 Go/s | Juste~109 tok/s | Rentre~23 tok/s |
Le Strix Halo 128 Go avec prix le moins cher, le boîtier GB10 le moins cher et le Mac Studio le moins cher avec une mémoire comparable.
Ryzen AI Max+ 395, 64GB / 1TB
64 Go · 256 Go/s · ~48 Go utilisables
Voir le prixRyzen AI Max+ 395, 128GB / 1TB
128 Go · 256 Go/s · ~96 Go utilisables
Voir le prixRyzen AI Max+ 395, 128GB / 2TB
128 Go · 256 Go/s · ~96 Go utilisables
Voir le prixRyzen AI Max+ 395, 128GB / 2TB
128 Go · 256 Go/s · ~96 Go utilisables
Voir le prixRyzen AI Max+ 395, 128GB
128 Go · 256 Go/s · ~96 Go utilisables
Voir le prixPour les modèles MoE, oui : avec 128 Go (~96 Go utilisables par défaut), il fait tourner GPT-OSS 120B à ~55 tok/s selon notre estimation; un essai public sous ROCm a mesuré 47,5 tok/s. Les modèles denses de 70B tournent, mais à environ 5 tok/s seulement.
Nous comptons ~75 % de la RAM utilisable par défaut (96 Go sur 128 Go). La limite du pilote peut être relevée par réglage : les modèles juste au-dessus de la limite peuvent donc quand même se charger.
Bande passante similaire (256 contre 273 Go/s) et 128 Go des deux côtés, mais le Strix Halo 128 Go le moins cher que nous suivons coûte 3 500 $ US, contre 5 859 $ US pour le boîtier GB10 le moins cher. Le Spark offre plus de mémoire utilisable (~85 %) et CUDA.
Un Mac Studio M5 Ultra de 96 Go a 1 200 Go/s : il est donc bien plus rapide par jeton, mais il coûte 5 499 $ US.
64 Go (~48 Go utilisables), c’est juste pour Llama 3.3 70B et insuffisant pour GPT-OSS 120B (~67 Go). Prenez 128 Go si vous visez des MoE de plus de 100B.
Un court courriel par semaine (en anglais pour l’instant) : ce qui a baissé, ce qui est de retour en stock et les nouveaux modèles ouverts que votre machine peut faire tourner. Désabonnement en un clic.