Strix Halo
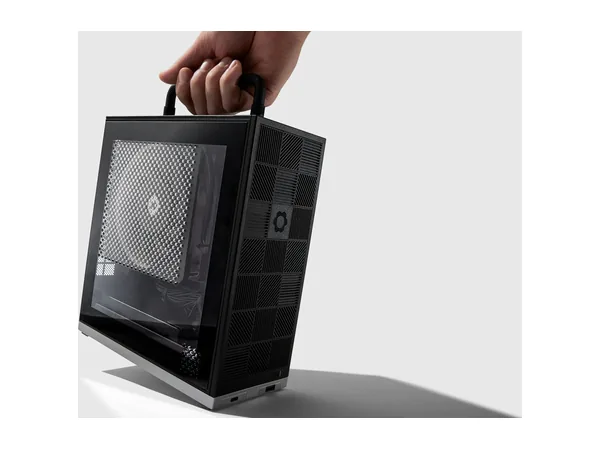
Framework Desktop DIY
Ryzen AI Max+ 395, 128GB
128 Go de mémoire unifiée LPDDR5x à 256 Go/s. Fait tourner jusqu’à Qwen3.5 122B-A10B, Nemotron 3 Super 120B-A12B, GPT-OSS 120B. Prix le plus bas trouvé : 4 839 $ US chez Framework store (vérifié le 2026-10-24).
4 839 $ USEn rupture
Prix US le plus bas vu, chez Framework store · vérifié le 2026-10-24 · USD, hors taxes et livraison
Voir le prix- Mémoire
- 128 Go ~96 Go utilisables pour les modèles
- Bande passante
- 256 Go/s détermine les jetons/s
- Logiciel
- ROCm ROCm / Vulkan
- Prix par Go
- 37,80 $ US de mémoire pour les modèles
Prix du système de base, sans stockage, OS ni cartes d’extension. Version 64 Go à 1 959 $ US (aussi en rupture).
Où l’acheter?
- Framework store 4 839 $ USEn ruptureVoir le prix
Prix US en dollars américains (USD), hors taxes et livraison. Le texte de stock est celui du détaillant (en anglais).
Quels LLM fait-il tourner, et à quelle vitesse?
Compatibilité et vitesse de génération estimées pour un utilisateur, avec ~8K de contexte. Notre méthode
- Qwen3.5 9Bdense · 9B actifs
Q4_K_MRentre~37 tok/s7 sur 96 GoQ8_0Rentre~21 tok/s12 sur 96 Go
- Gemma 4 12Bdense · 12B actifs
Q4_K_MRentre~28 tok/s9 sur 96 GoQ8_0Rentre~16 tok/s15 sur 96 Go
- GPT-OSS 20BMoE · 3.6B actifs
MXFP4 (native)Rentre~69 tok/s13 sur 96 GoQ8_0Rentre~42 tok/s25 sur 96 Go
- Gemma 4 26B-A4BMoE · 3.8B actifs
Q4_K_MRentre~61 tok/s18 sur 96 GoQ8_0Rentre~40 tok/s30 sur 96 Go
- Qwen3.8 27Bdense · 27B actifs
Q4_K_MRentre~12 tok/s19 sur 96 GoQ8_0Rentre~7 tok/s32 sur 96 Go
- GLM-4.7-Flash 30B-A3BMoE · 3B actifs
Q4_K_MRentre~72 tok/s21 sur 96 GoQ8_0Rentre~48 tok/s35 sur 96 Go
- Gemma 4 31Bdense · 31B actifs
Q4_K_MRentre~11 tok/s21 sur 96 GoQ8_0Rentre~6 tok/s36 sur 96 Go
- Qwen3.6 35B-A3BMoE · 3B actifs
Q4_K_MRentre~72 tok/s24 sur 96 GoQ8_0Rentre~48 tok/s41 sur 96 Go
- Llama 3.3 70Bdense · 70B actifs
Q4_K_MRentre~5 tok/s46 sur 96 GoQ8_0Rentre~3 tok/s80 sur 96 Go
- Qwen3-Next 80B-A3BMoE · 3B actifs
Q4_K_MRentre~72 tok/s52 sur 96 GoQ8_0Juste~48 tok/s91 sur 96 Go
- Llama 4 Scout 109B-A17BMoE · 17B actifs
Q4_K_MRentre~18 tok/s71 sur 96 GoQ8_0Ne rentre pasil faut ~123 Go
- GPT-OSS 120BMoE · 5.1B actifs
MXFP4 (native)Rentre~55 tok/s67 sur 96 GoQ8_0Ne rentre pasil faut ~132 Go
- Nemotron 3 Super 120B-A12BMoE · 12B actifs
Q4_K_MRentre~25 tok/s78 sur 96 GoQ8_0Ne rentre pasil faut ~135 Go
- Qwen3.5 122B-A10BMoE · 10B actifs
Q4_K_MRentre~29 tok/s79 sur 96 GoQ8_0Ne rentre pasil faut ~138 Go
- Qwen3 235B-A22BMoE · 22B actifs
Q4_K_MNe rentre pasil faut ~151 GoQ8_0Ne rentre pasil faut ~264 Go
- Muse Spark Open 816B-A42BMoE · 42B actifs
Q4_K_MNe rentre pasil faut ~521 GoQ8_0Ne rentre pasil faut ~912 Go
Image : Framework product page og:image