Framework Desktop DIY vs GMKtec EVO-X2 pour faire tourner un LLM en local
Le GMKtec EVO-X2 devrait générer les jetons plus vite (plus de bande passante mémoire). Les deux acceptent les mêmes tailles de modèles. Le GMKtec EVO-X2 coûte actuellement 1 339 $ US de moins.
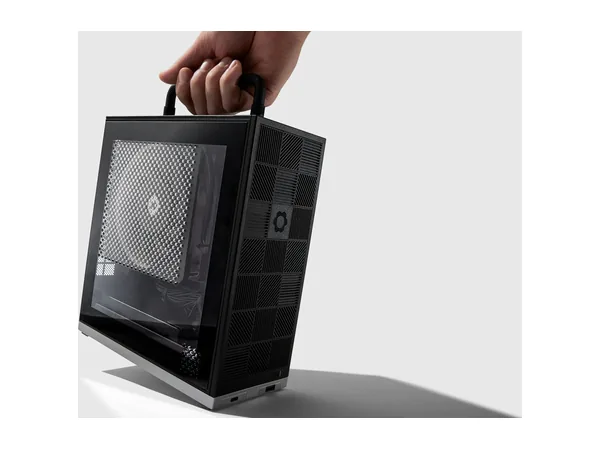
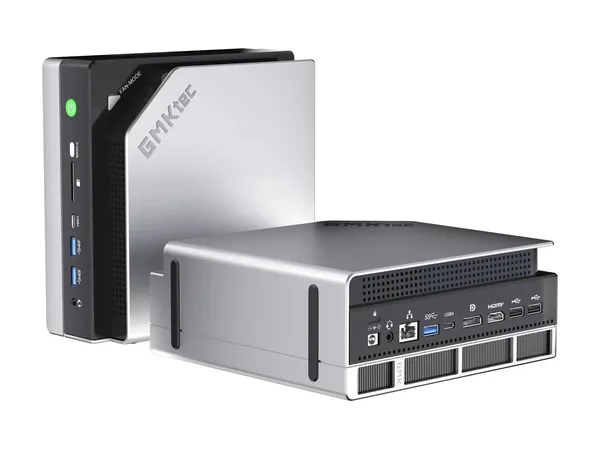
Comment se comparent leurs fiches techniques?
| Framework Desktop DIY | GMKtec EVO-X2 | |
|---|---|---|
| Stock | En rupture | Disponible |
| Prix le plus bas (USD) | 4 839 $ US | 3 500 $ US |
| Mémoire | 128 Go mémoire unifiée LPDDR5x | 128 Go mémoire unifiée LPDDR5X-8000 |
| Utilisable pour les modèles (est.) | ~96 Go | ~96 Go |
| Bande passante | 256 Go/s | 256 Go/s |
| Logiciel | ROCm / Vulkan | ROCm / Vulkan |
| Prix par Go | 37,80 $ US | 27,34 $ US |
Prix US en dollars américains (USD), hors taxes et livraison.
Lequel fait tourner chaque modèle le plus vite (4 bits)?
| Modèle | Framework Desktop DIY | GMKtec EVO-X2 |
|---|---|---|
| Qwen3.5 9B | Rentre~37 tok/s | Rentre~37 tok/s |
| Gemma 4 12B | Rentre~28 tok/s | Rentre~28 tok/s |
| GPT-OSS 20B | Rentre~69 tok/s | Rentre~69 tok/s |
| Gemma 4 26B-A4B | Rentre~61 tok/s | Rentre~61 tok/s |
| Qwen3.8 27B | Rentre~12 tok/s | Rentre~12 tok/s |
| GLM-4.7-Flash 30B-A3B | Rentre~72 tok/s | Rentre~72 tok/s |
| Gemma 4 31B | Rentre~11 tok/s | Rentre~11 tok/s |
| Qwen3.6 35B-A3B | Rentre~72 tok/s | Rentre~72 tok/s |
| Llama 3.3 70B | Rentre~5 tok/s | Rentre~5 tok/s |
| Qwen3-Next 80B-A3B | Rentre~72 tok/s | Rentre~72 tok/s |
| Llama 4 Scout 109B-A17B | Rentre~18 tok/s | Rentre~18 tok/s |
| GPT-OSS 120B | Rentre~55 tok/s | Rentre~55 tok/s |
| Nemotron 3 Super 120B-A12B | Rentre~25 tok/s | Rentre~25 tok/s |
| Qwen3.5 122B-A10B | Rentre~29 tok/s | Rentre~29 tok/s |
| Qwen3 235B-A22B | Ne rentre pas | Ne rentre pas |
| Muse Spark Open 816B-A42B | Ne rentre pas | Ne rentre pas |