DGX SparkEn rupture
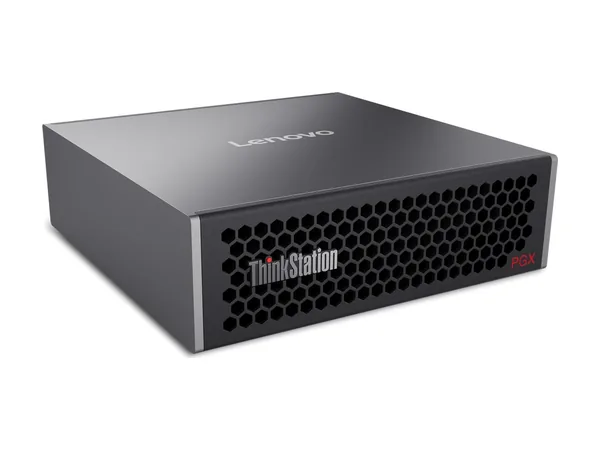
Lenovo ThinkStation PGX
1TB
5 859 $ USchez B&H Photo
128 Go · 273 Go/s
Rentre~5 tok/sQ4_K_M
Voir le prixEst-ce que ça tourne? · Llama 3.3 70B sur DGX Spark
Oui, mais lentement. Llama 3.3 70B demande environ 46 Go en Q4_K_M et un DGX Spark offre ~109 Go utilisables sur 128 Go : il rentre donc. Comme chaque jeton lit les 70B de poids à 273 Go/s, nous estimons seulement ~5 tok/s en 4 bits (3 tok/s en Q8_0, qui demande ~80 Go).
Le seul essai public de 70B que nous avons trouvé sur un boîtier GB10 a mesuré 4,7 tok/s (Dell Pro Max GB10, Ollama (Geerling)), contre 4,9 selon notre formule.
| Q4_K_M (4 bits) | Q8_0 (8 bits) | |
|---|---|---|
| Mémoire nécessaire | ~46 Go | ~80 Go |
| Utilisable sur le DGX Spark | ~109 Go | ~109 Go |
| Compatibilité | Rentre~5 tok/s | Rentre~3 tok/s |
Mémoire = poids + 1,5 Go + 5 % des poids (~8K de contexte, un utilisateur). Vitesse = 1 ÷ (Go actifs ÷ (77 % × 273 Go/s) + surcoût par jeton). Notre méthode
| Matériel | Modèle / essai | tok/s mesurés | Notre formule | Source |
|---|---|---|---|---|
| Strix Halo256 Go/s | Llama 3.3 70B Q4_K_Mllama.cpp Vulkan tg128 | 4,8 | 4,8 | source |
| M3 Ultra 80c819 Go/s | Llama 3.3 70B 4-bitMLX (oMLX) 1K ctx | 17,0 | 16,8 | source |
| RTX PRO 60001 792 Go/s | Llama 3.3 70B Q4_K_Mllama.cpp tg128 | 34,0 | 33,8 | source |
| Framework Desktop (Strix Halo)256 Go/s | Llama 3.1 70B Q4_K_MOllama (Geerling) | 5,0 | 4,8 | source |
| Dell Pro Max GB10273 Go/s | Llama 3.1 70B Q4_K_MOllama (Geerling) | 4,7 | 4,9 | source |
| M3 Ultra 512GB819 Go/s | Llama 3.1 70B Q4_K_MOllama (Geerling) | 14,1 | 15,7 | source |
Résultats publics de génération pour un utilisateur, utilisés pour calibrer la formule. Liste complète : nos estimations face à 52 vrais bancs d’essai.
| Machine | Prix US (USD) | Bande passante | Compatibilité et vitesse est. en 4 bits |
|---|---|---|---|
| PNY NVIDIA RTX PRO 6000 BlackwellRTX PRO 6000 (carte seule, il faut un PC hôte) | 17 899 $ US | 1 792 Go/s | Rentre~34 tok/s |
| Mac Studio M5 UltraMac Studio | 5 499 $ US | 1 200 Go/s | Rentre~23 tok/s |
| Lenovo ThinkStation PGXDGX Spark / GB10 | 5 859 $ US | 273 Go/s | Rentre~5 tok/s |
| GMKtec EVO-X2Strix Halo | 2 200 $ US | 256 Go/s | Juste~5 tok/s |
La config avec prix la moins chère de chaque plateforme où il rentre, de la plus rapide à la plus lente. La vitesse d’un 70B dense suit presque exactement la bande passante mémoire. Plus de détails : meilleur matériel pour Llama 3.3 70B.
Les 128 Go du Spark servent mieux les gros modèles à mélange d’experts, qui ne lisent qu’une partie de leurs poids à chaque jeton :
1TB
128 Go · 273 Go/s
1TB
128 Go · 273 Go/s
Founders Edition, 4TB
128 Go · 273 Go/s
4TB
128 Go · 273 Go/s
4TB
128 Go · 273 Go/s
Oui. En Q4_K_M, il faut environ 46 Go et le Spark offre ~109 Go utilisables : il rentre, avec de la marge pour un contexte plus long. Comptez environ 5 jetons/s (notre estimation) pour un utilisateur.
Environ 5 tok/s en 4 bits et 3 tok/s en 8 bits selon notre formule fondée sur la bande passante. Un essai public sur Dell Pro Max GB10 a mesuré 4,7 tok/s. C’est lisible, mais lent pour le chat; le traitement du prompt est le point fort du Spark.
Parmi les boîtiers GB10 que nous suivons, le Lenovo ThinkStation PGX à 5 859 $ US (B&H Photo, vérifié le 2026-10-24). Ils partagent tous la même puce GB10, 128 Go et 273 Go/s : la vitesse en 70B est donc la même sur chacun.
Oui : le Q8_0 demande environ 80 Go sur les ~109 Go utilisables, mais la vitesse tombe à ~3 tok/s.
Les modèles à mélange d’experts (MoE) ne lisent que leurs poids actifs à chaque jeton, ils sont donc bien plus rapides : Qwen3.5 122B-A10B ~31 tok/s; Nemotron 3 Super 120B-A12B ~26 tok/s; GPT-OSS 120B ~61 tok/s; Llama 4 Scout 109B-A17B ~19 tok/s.
Un court courriel par semaine (en anglais pour l’instant) : ce qui a baissé, ce qui est de retour en stock et les nouveaux modèles ouverts que votre machine peut faire tourner. Désabonnement en un clic.