ASUS Ascent GX10 vs NVIDIA DGX Spark pour faire tourner un LLM en local
Le NVIDIA DGX Spark devrait générer les jetons plus vite (plus de bande passante mémoire). Les deux acceptent les mêmes tailles de modèles. Le ASUS Ascent GX10 coûte actuellement 951,00 $ US de moins.
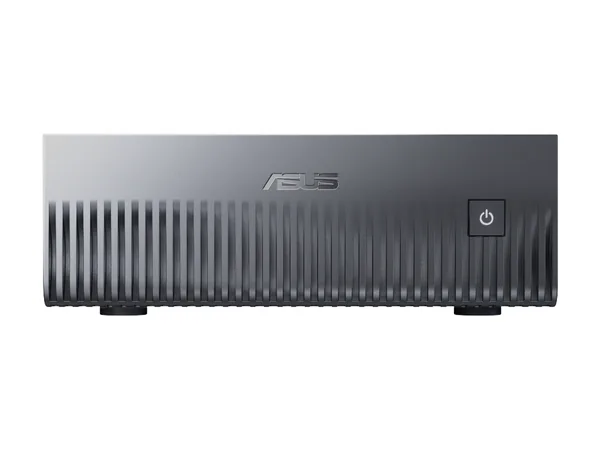
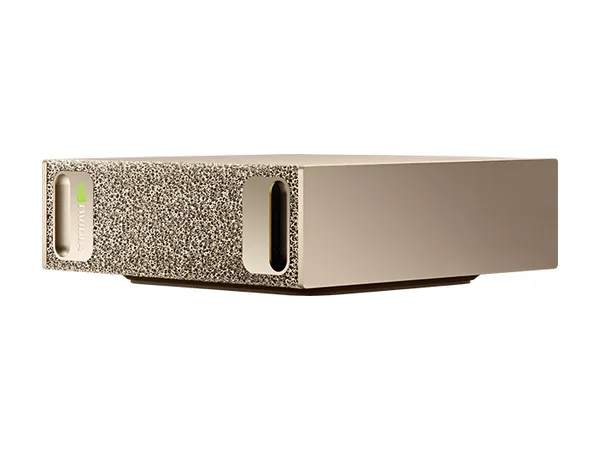
Comment se comparent leurs fiches techniques?
| ASUS Ascent GX10 | NVIDIA DGX Spark | |
|---|---|---|
| Stock | En rupture | Disponible |
| Prix le plus bas (USD) | 5 999 $ US | 6 950 $ US |
| Mémoire | 128 Go mémoire unifiée LPDDR5x | 128 Go mémoire unifiée LPDDR5x |
| Utilisable pour les modèles (est.) | ~109 Go | ~109 Go |
| Bande passante | 273 Go/s | 273 Go/s |
| Logiciel | CUDA | CUDA |
| Prix par Go | 46,87 $ US | 54,30 $ US |
Prix US en dollars américains (USD), hors taxes et livraison.
Lequel fait tourner chaque modèle le plus vite (4 bits)?
| Modèle | ASUS Ascent GX10 | NVIDIA DGX Spark |
|---|---|---|
| Qwen3.5 9B | Rentre~39 tok/s | Rentre~39 tok/s |
| Gemma 4 12B | Rentre~29 tok/s | Rentre~29 tok/s |
| GPT-OSS 20B | Rentre~80 tok/s | Rentre~80 tok/s |
| Gemma 4 26B-A4B | Rentre~70 tok/s | Rentre~70 tok/s |
| Qwen3.8 27B | Rentre~13 tok/s | Rentre~13 tok/s |
| GLM-4.7-Flash 30B-A3B | Rentre~83 tok/s | Rentre~83 tok/s |
| Gemma 4 31B | Rentre~11 tok/s | Rentre~11 tok/s |
| Qwen3.6 35B-A3B | Rentre~83 tok/s | Rentre~83 tok/s |
| Llama 3.3 70B | Rentre~5 tok/s | Rentre~5 tok/s |
| Qwen3-Next 80B-A3B | Rentre~83 tok/s | Rentre~83 tok/s |
| Llama 4 Scout 109B-A17B | Rentre~19 tok/s | Rentre~19 tok/s |
| GPT-OSS 120B | Rentre~61 tok/s | Rentre~61 tok/s |
| Nemotron 3 Super 120B-A12B | Rentre~26 tok/s | Rentre~26 tok/s |
| Qwen3.5 122B-A10B | Rentre~31 tok/s | Rentre~31 tok/s |
| Qwen3 235B-A22B | Ne rentre pas | Ne rentre pas |
| Muse Spark Open 816B-A42B | Ne rentre pas | Ne rentre pas |